Linear Regression


Premier projet de Machine Learning : une régression linéaire codée de zéro, entraînée par une descente de gradient.
Présentation
Le projet Linear Regression consiste à écrire, sans aucune bibliothèque de machine learning, une régression linéaire simple :
θ₀: le prix de départ (voiture à 0 km)θ₁: la perte de valeur par kilomètre
Le but de l'apprentissage : trouver les meilleurs θ₀ et θ₁ pour que cette droite colle au mieux aux 24 données réelles du sujet (kilométrage → prix de voiture d'occasion).
Le cœur du projet est la descente de gradient : un algorithme d'optimisation itératif qui ajuste les paramètres petit à petit, comme s'il descendait une colline jusqu'à trouver la vallée (le minimum de l'erreur).
Le projet
Introduction au machine learning.
L'objectif : vivre le premier algorithme d'apprentissage automatique de bout en bout, sans boîte noire.
La règle du jeu
Aucune triche possible : numpy.polyfit et scikit-learn sont interdits.
Tout est implémenté à la main :
- La normalisation.
- Les gradients.
- Les métriques.
- Les graphiques.
Le programme final se compose de deux scripts qui communiquent :
entrainement.py: Litdata.csv, exécute la descente de gradient et sauvegardeθ₀etθ₁dansthetas.jsonpredict_prix.py: Recharge le fichier, demande un kilométrage à l'utilisateur et prédit le prix
En bonus : le calcul de précision MSE, MAE, R² et la visualisation de la droite de régression.
La descente de gradient : le cœur du projet
1. Normaliser pour stabiliser
Le kilométrage (jusqu'à 240 000) et le prix (quelques milliers) n'ont pas la même échelle. Sans normalisation, la descente oscillerait ou divergerait. On ramène tout vers [0, 1] :
2. Boucle d'entraînement (10 000 itérations)
À chaque itération, on mesure l'erreur du modèle courant, puis on calcule les gradients: la direction dans laquelle la fonction de coût (MSE) monte :
y_pred          = θ₀ + θ₁ · x_norm          # prédiction actuelle
gradient_θ₀     = (1/n) · Σ erreur          # dérivée partielle / θ₀
gradient_θ₁     = (1/n) · Σ (erreur · x)    # dérivée partielle / θ₁
θ₀ -= 0.01 · gradient_θ₀                    # un petit pas dans le SENS
θ₁ -= 0.01 · gradient_θ₁                    # OPPOSÉ du gradient
Pourquoi simultanément ?
Les deux mises à jour se font à partir des mêmes prédictions. Si l'on modifie θ₀ avant de calculer le gradient de θ₁, l'algorithme diverge.
3. Dénormaliser et sauvegarder
L'entraînement a eu lieu sur des données [0, 1] : on ramène θ₀ et θ₁ à l'échelle réelle (€, km) puis on les sauvegarde pour la prédiction :
4. Cycle d'utilisation
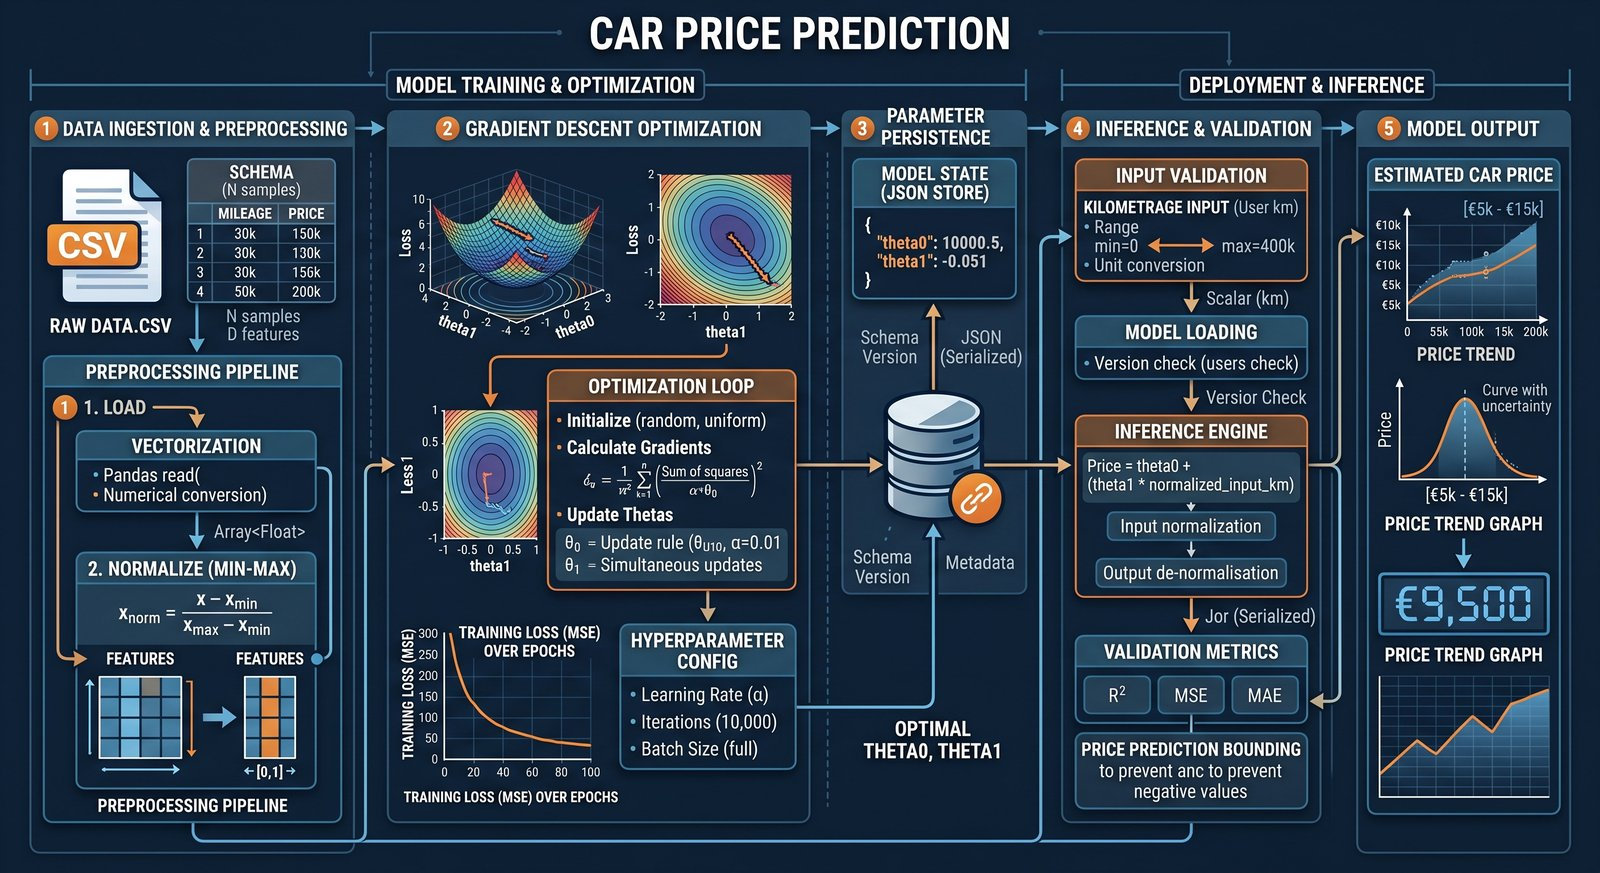
- Ingestion & Prétraitement des données : Chargement du fichier data.csv et normalisation Min-Max des variables (kilométrage et prix) vers l'intervalle
[0, 1]pour garantir la stabilité de l'entraînement. - Optimisation par descente de gradient : Boucle d'entraînement itérative (10 000 étapes) minimisant la fonction de coût MSE pour ajuster simultanément les paramètres
theta_0ettheta_1. - Persistance des paramètres : Dénormalisation des coefficients appris et sauvegarde sous forme sérialisée dans le fichier
thetas.json. - Inférence & Validation : Contrôle des saisies utilisateur (kilométrage), chargement des thétas, calcul de la prédiction et évaluation du modèle via les métriques
R²,MSEetMAE. - Restitution du résultat : Génération du prix estimé (avec sécurité anti-valeur négative) et affichage de la droite de régression sur le nuage de points.
Extension : les moindres carrés
Après le projet, j'ai ajouté une deuxième implémentation pour comparer les approches : la méthode des moindres carrés (OLS), qui résout le même problème de manière analytique.
Une formule fermée, sans itération :
Deux cas d'usage ont été ajoutés : prédiction d'une note d'école selon les heures d'étude, et du prix d'une voiture (version OLS).
| Moindres carrés | Descente de gradient | |
|---|---|---|
| Résolution | Analytique (formule fermée) | Itérative (10 000 étapes) |
| Normalisation | Aucune | Min-max vers [0, 1] |
| Persistance | Calcul à la volée | thetas.json |
| Évaluation | Visuel uniquement | MSE, MAE, R² |
Architecture
Le dépôt public est organisé en deux parties indépendantes, chacune autonome :
linear-regression/
├── requirements.txt
├── method_moindre_carre/            # Extension : moindres carrés (OLS)
│   ├── predict_note_ecole/          # Prédiction de notes selon les heures d'étude
│   └── predict_prix_voiture/        # Prédiction du prix selon le kilométrage
└── method_decente_gradient/         # LINEAR REGRESSION : descente de gradient
    ├── entrainement.py              # Entraîne le modèle: thetas.json
    ├── predict_prix.py              # Prédiction interactive du prix
    ├── bonus.py                     # Évaluation (MSE, MAE, R²) + visualisation
    ├── logger.py                    # Logging coloré partagé
    └── utils.py                     # Chargement CSV, lecture des thetas
Technologies
Python
scripting, typage des entrées de fonctions
NumPy
calcul vectoriel et tableaux
Pandas
chargement et manipulation des CSV
Matplotlib
nuage de points et droite de régression
Descente de gradient
optimisation itérative, 10 000 étapes, taux d'apprentissage 0,01
Moindres carrés (OLS)
solution analytique (extension)
zéro scikit-learn
ni polyfit, ni LinearRegression : tout est écrit à la main
Fonctionnalités
| Script | Rôle | Méthode |
|---|---|---|
entrainement.py | Ajuster θ₀ et θ₁, sauvegarder thetas.json | Descente de gradient |
predict_prix.py | Prédiction interactive du prix (demande le km) | Descente de gradient |
bonus.py | MSE, MAE, R² + graphique regression_lineaire.png | Évaluation |
predict_note.py | Prédire une note (/10) selon les heures d'étude | Extension OLS |
predict_prix.py (OLS) | Prédire un prix selon le kilométrage configurable | Extension OLS |
Problème | Solution
| Problème | Solution |
|---|---|
| Apprendre le ML sans bibliothèque toute faite | Implémenter la descente de gradient à la main : gradients, pas d'apprentissage, convergence |
| Instabilité avec des échelles très différentes | Normalisation min-max des données vers [0, 1], puis dénormalisation de θ₀ et θ₁ |
| Mettre à jour θ₀ et θ₁ sans quoi rien ne converge | Calcul des deux gradients à partir des mêmes prédictions, puis mise à jour simultanée |
| Un kilométrage extrême donne un prix négatif | Détection dans predict_prix.py : prix négatif → avertissement au lieu d'une prédiction absurde |
| Mesurer la qualité du modèle | Bonus : calcul de MSE, MAE et R² |
| Expliquer visuellement le résultat | Graphique Matplotlib : nuage de points + droite de régression |
| Garder les paramètres entre entraînement et prédiction | Sauvegarde de θ₀ et θ₁ dans thetas.json |
Résultats
- Droite de régression finale (descente de gradient, 10 000 itérations) :
θ₀ = 8 480,97: Prix estimé d'une voiture à 0 kmθ₁ = -0,0213: Perte de valeur par kilomètre- Métriques d'évaluation (
bonus.py) : - MAE = 556,48 € : Erreur moyenne absolue
- MSE = 445 729,27 €² : Erreur quadratique moyenne
- R² = 0,733 : 73 % de la variance du prix expliquée par le kilométrage
- Estimation à 100 000 km : ≈ 6 353 € · à 240 000 km (max du jeu) : ≈ 3 376 €
- L'extension moindres carrés converge vers les mêmes paramètres: preuve que les deux approches résolvent le même problème
Ce que j'ai appris
Une régression linéaire est un problème d'optimisation : trouver les paramètres qui minimisent l'erreur.
La descente de gradient m'a fait comprendre que l'apprentissage automatique est une boucle de rétroaction:
- Prédire
- Mesurer l'écart
- Corriger un petit pas à la fois
Et que la normalisation des données peut changer radicalement la stabilité d'un algorithme.
Écrire les gradients à la main m'a aussi fait comprendre pourquoi les frameworks de ML existent… et pourquoi il vaut mieux savoir ce qu'ils font avant de les utiliser.
Tutoriel : Régression linéaire de zéro
Tu veux reproduire ce projet pas à pas ?
Le tutoriel couvre la théorie, la descente de gradient, la méthode des moindres carrés, l'évaluation et la visualisation avec le vrai code du dépôt.